What it does
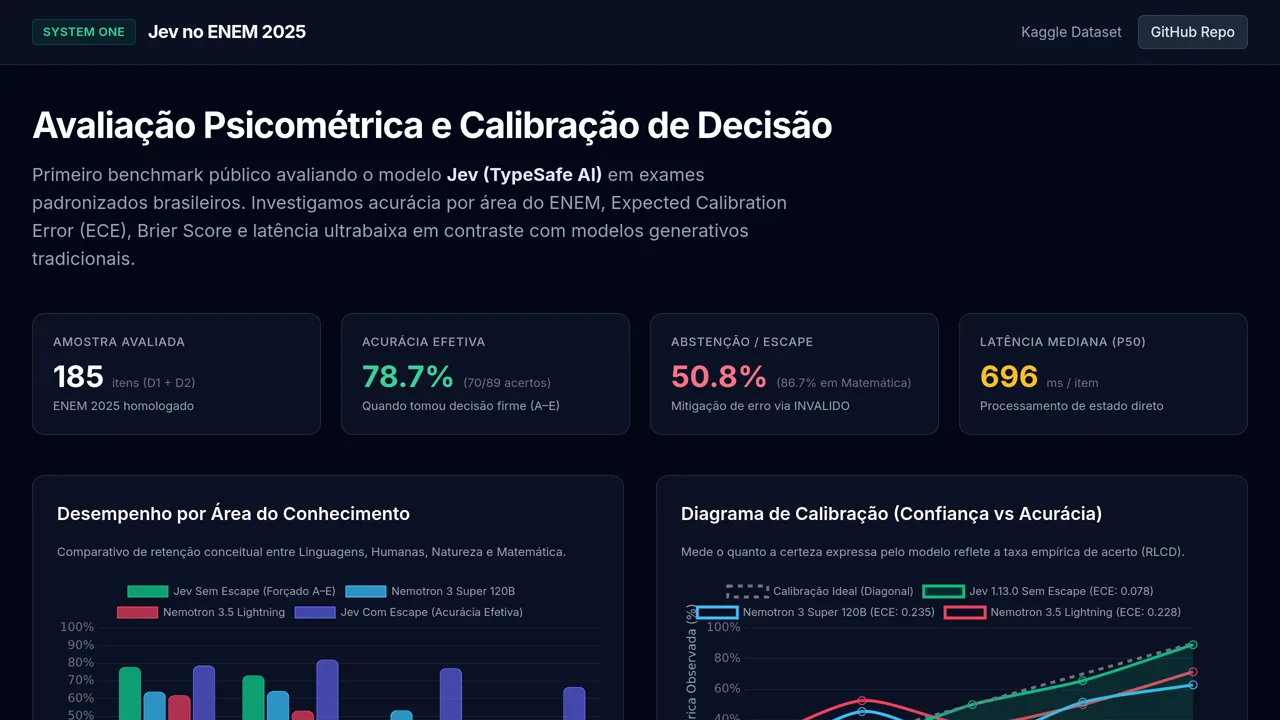
An escape option that lets the model abstain works as an uncertainty filter: items Jev accepted were 78.8% correct, while items it had rejected scored 35.5% when forced.
Maker-reported (not independently measured by JevMade): Concordância Intra-Modelo de 97.7% · 78.8% accuracy on accepted items vs 35.5% on forced-INVALIDO items · Caderno Azul — 1º e 2º Dias
- Primitives
- choice
- Platform
- Python
- Added
- Project created
Source checked 2026-09-24 — opened the GitHub repository directly.